Wenn Sie KI mit Dokumenten nutzen wollen, die personenbezogene Daten enthalten, muss ein Pseudonymisierungstool vier Dinge richtig machen. Ihre Datei wird dort verarbeitet, wo Sie es für vertretbar halten. Jede Person erhält in jedem Dokument denselben Platzhalter. Der Schlüssel, der den Austausch umkehrt, wird sicher aufbewahrt. Und Sie können prüfen und korrigieren, was das Tool gefunden hat. Der Rest dieser Checkliste zeigt, ob ein Tool zu Ihren Dokumenten, Ihrem Team und Ihrem Budget passt.
Was das Tool leisten muss
Nach der DSGVO bedeutet Pseudonymisierung, personenbezogene Daten so zu verarbeiten, dass sie ohne zusätzliche Informationen keiner Person mehr zugeordnet werden können, wobei diese Informationen gesondert aufbewahrt und geschützt werden (Artikel 4 Nr. 5). Pseudonymisierte Daten bleiben personenbezogene Daten. Was das für KI-Chatbots bedeutet, erklärt der Beitrag DSGVO und pseudonymisierte Daten in der KI.
Für die Arbeit mit KI sieht die Aufgabe so aus. Namen, Adressen und Nummern werden zu Platzhaltern wie Person_1. Die KI arbeitet mit den Platzhaltern. Auf Ihrer Seite verwandelt ein Schlüssel sie in der Antwort wieder in Namen. Brauchen Sie die Namen nie zurück, ist vielleicht Anonymisierung oder Schwärzung das Richtige: Siehe welches der drei Verfahren Sie brauchen.
Wohin Ihre Daten gehen
- Wo die Verarbeitung stattfindet. Entweder auf Ihrem Computer oder auf den Servern des Anbieters, nachdem Sie die Datei hochgeladen haben. Im zweiten Fall erreicht das Original mit allen Namen einen Dritten, bevor es geschützt ist. Unser Vergleich lokaler und Online-Tools listet die Fragen an einen Online-Anbieter auf und einen einfachen Test für eine Desktop-App: Netzwerk abschalten und ausprobieren.
- Was danach mit den Daten geschieht. Bei einem Cloud-Dienst: wie lange Dateien und Ergebnisse gespeichert werden, in welcher Region und wer die Unterauftragsverarbeiter sind. Bei einer Desktop-App: was sie auf Ihre Festplatte schreibt und wie Sie es löschen.
- Protokolle. Ein Nachweis, wann Dokumente verarbeitet wurden, ist nützlich, wenn ein Mandant oder Ihr Datenschutzbeauftragter nachfragt. Prüfen Sie, dass das Protokoll selbst keine personenbezogenen Daten enthält.
Ob Sie die Namen zurückbekommen
- Einheitlichkeit. Dieselbe Person sollte in jedem Absatz und in jedem Dokument einer Angelegenheit denselben Platzhalter erhalten. Sonst erkennt die KI nicht, dass die Mieterin im Mietvertrag und die Absenderin der E-Mail dieselbe Person sind. Fragen Sie, wie das Tool mit Varianten wie „Maria Lopez“, „Frau Lopez“ und „M. Lopez“ umgeht.
- Umkehrbarkeit. Manche Tools ersetzen Daten nur in eine Richtung. Andere führen eine Tabelle, die Platzhalter mit echten Namen verknüpft, oder verschlüsseln die Werte mit einem Schlüssel, der sie später entschlüsseln kann.
- Wo der Schlüssel liegt. Die Tabelle oder der Schlüssel sind die „zusätzlichen Informationen“, von denen die Definition der DSGVO spricht. Fragen Sie, wo sie gespeichert werden, ob sie verschlüsselt sind, wer sie öffnen kann und wann sie gelöscht werden. Kann jeder, der die sichere Kopie hat, auch den Schlüssel lesen, schützt die Pseudonymisierung wenig.
Ob es zu Ihren Dokumenten passt
- Erkannte Datentypen. Namen, Firmen, Adressen, Telefonnummern, E-Mail-Adressen, Konto- und Ausweisnummern, Geburtsdaten. Wenn Sie grenzüberschreitend arbeiten, prüfen Sie nationale Ausweis- und Steuernummern der Länder, mit denen Sie zu tun haben. Funktionsbezeichnungen, Spitznamen und seltene Details sind für jeden Erkenner schwierig, einige davon werden Sie von Hand markieren.
- Ein Prüfschritt. Die Erkennung ist nie vollständig. Selbst die Dokumentation von Presidio, einem verbreiteten Open-Source-Erkenner, sagt, es gebe keine Garantie, dass alle sensiblen Informationen gefunden werden. Sie müssen jeden Treffer sehen, falsche abwählen und Übersehenes ergänzen können, bevor etwas hinausgeht.
- Dateiformate. PDF, Word, Excel, E-Mails. Gescannte PDFs und Fotos von Dokumenten brauchen Texterkennung. Manche Tools akzeptieren nur reinen Text, dann konvertieren Sie jede Datei selbst.
- Sprachen. Die Erkennung hängt von der Sprache ab. Testen Sie mit echten Dokumenten in jeder Sprache, in der Sie arbeiten.
Für wen es gemacht ist und was es kostet
- Entwickler oder Büroanwender. Eine Bibliothek oder API braucht jemanden, der sie installiert, Code darum herum schreibt und sie am Laufen hält. Eine Desktop-App muss nur installiert werden. Sie sind für unterschiedliche Menschen gemacht, und keine ist grundsätzlich besser.
- Preismodell. Bezahlung nach Volumen (pro Gigabyte oder pro hundert Zeichen), ein Abonnement pro Nutzer, ein einmaliger Kauf oder kostenloses Open Source plus die Zeit Ihrer Mitarbeiter. Rechnen Sie die jährlichen Kosten für das Volumen aus, das Sie tatsächlich erwarten.
Vier Arten von Tools
Die Beispiele unten sind die, die wir anhand der Herstellerdokumentation prüfen konnten. Funktionen und Preise Stand Oktober 2026.
Open-Source-Bibliotheken für Entwickler
Presidio ist ein MIT-lizenziertes Framework zum Finden und De-Identifizieren personenbezogener Daten. Es entstand bei Microsoft und ist heute ein Community-Projekt unter der Organisation Data Privacy Stack. Sein Anonymisierer kann jedes gefundene Element ersetzen, schwärzen, maskieren, hashen oder verschlüsseln, und verschlüsselte Werte lassen sich mit demselben Schlüssel entschlüsseln. Ein separates Modul findet und schwärzt Text in Bildern per OCR.
Es ist kostenlos, läuft auf Ihren eigenen Rechnern und lässt sich für fast jede Verarbeitungskette anpassen. Es ist eher ein Baukasten als eine Anwendung: Die Installation bedeutet Python-Pakete, den Download eines Sprachmodells und Code, den Sie selbst schreiben. Prüfansichten, Fallverwaltung und Dateikonvertierung bauen Sie selbst.
Cloud-Dienste für Datenschutz
Google Cloud Sensitive Data Protection findet sensible Daten mit einer langen Liste eingebauter Erkenner und kann sie durch Token ersetzen. Deterministische und formaterhaltende Verschlüsselung liefern für denselben Wert dasselbe Token, und mit dem Schlüssel lassen sich die Daten re-identifizieren. Google empfiehlt, diesen Schlüssel mit Cloud Key Management Service zu sichern. Der Dienst kann auch Bilder schwärzen, indem er Funde mit undurchsichtigen Kästen abdeckt. Abgerechnet wird pro Gigabyte.
Amazon Comprehend erkennt personenbezogene Daten in englischem oder spanischem Text. Die Schwärzung läuft als Batch-Job über Dateien in Amazon S3 und ersetzt jedes Element durch seinen Typ, etwa [NAME], oder durch ein Maskenzeichen, sodass zwei verschiedene Personen beide zu [NAME] werden. Abgerechnet wird in Einheiten von 100 Zeichen.
Diese Dienste bewältigen große Mengen und sind in die übrige Cloud-Umgebung eines Unternehmens eingebunden, unter dessen eigenem Konto und Vertrag. Sie sind für Entwickler und IT-Teams gemacht.
Schwärzung in PDF-Editoren
In Adobe Acrobat Pro ersetzt die Schwärzung Text oder Bilder durch farbige Kästen und lässt sich nach dem Speichern nicht rückgängig machen. Ein separater Bereinigungsschritt (Sanitize) entfernt versteckte Daten wie Metadaten. Das ist das richtige Werkzeug für ein Dokument, das Sie einem Gericht, einer Gegenpartei oder einer Aufsichtsbehörde übergeben. Für den Weg zur KI und zurück passt es nicht: Schwarze Kästen sagen der KI nicht, wer wer ist, und es gibt nichts umzukehren. Siehe Platzhalter statt schwarzer Balken.
Desktop-Apps für Büroanwender
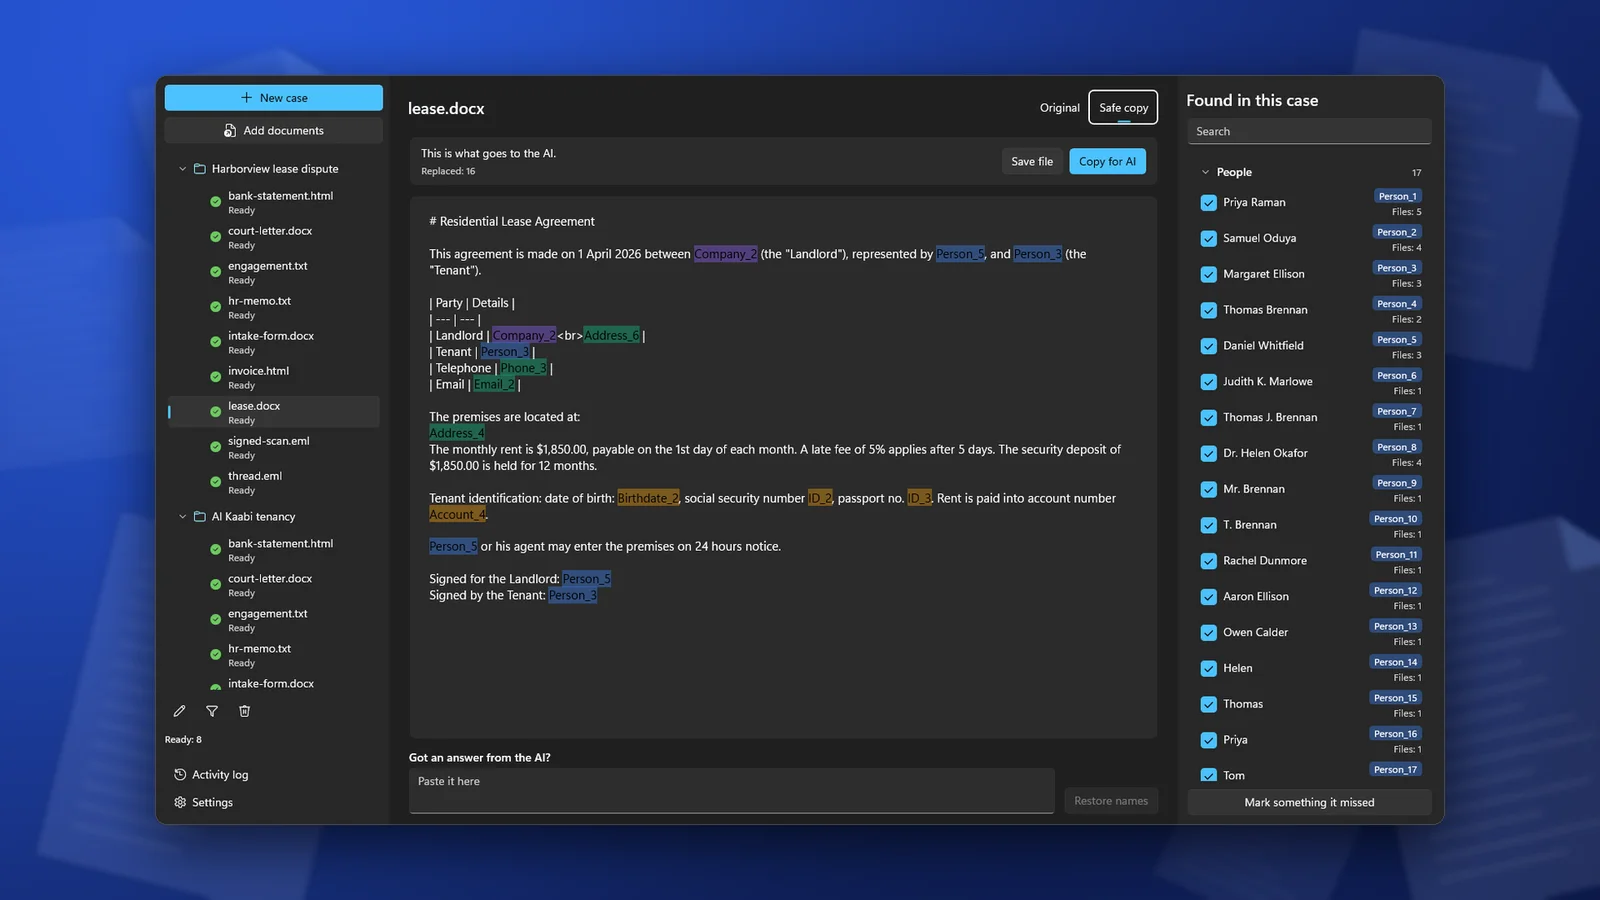
ClientSafe gehört dazu. Es läuft auf einem Windows-PC und verwaltet Dokumente in Fällen, sodass derselbe Name in jedem Dokument eines Falls denselben Platzhalter erhält. Sie prüfen, was gefunden wurde, entfernen das Häkchen bei Treffern, die keine personenbezogenen Daten sind, und markieren, was übersehen wurde. Sie kopieren die sichere Kopie in einen KI-Chat oder speichern sie als Markdown-Datei. Dann fügen Sie die Antwort der KI wieder ein, und ClientSafe setzt die echten Namen ein. Die Tabelle, die Platzhalter mit Namen verknüpft, bleibt verschlüsselt auf dem PC, bis Sie den Fall löschen. Es ist kein Schwärzungstool für Gerichtsschriftsätze oder für Dokumente, die Sie an eine andere Partei senden.
Im direkten Vergleich
| Kriterium | Entwicklerbibliothek (Presidio) | Cloud-Dienst (Google, Amazon) | PDF-Schwärzung (Acrobat Pro) | Desktop-App (ClientSafe) |
|---|---|---|---|---|
| Wo es läuft | Auf Ihren eigenen Rechnern | In der Cloud des Anbieters, unter Ihrem Konto | Im PDF-Editor | Auf Ihrem PC |
| Derselbe Platzhalter für dieselbe Person | Wenn Sie es einrichten | Google: mit deterministischer Verschlüsselung. Amazon-Schwärzung: nur Typbezeichnungen | Nein, schwarze Kästen | Ja, innerhalb eines Falls |
| Umkehrbar | Mit Verschlüsselung oder eigener Zuordnung | Google: mit dem Schlüssel. Amazon-Schwärzung: nein | Nein, absichtlich | Ja, Antwort wieder einfügen |
| Wo der Schlüssel liegt | Wo Ihr Code ihn ablegt | Google empfiehlt Cloud KMS | Kein Schlüssel | Verschlüsselt auf Ihrem PC, bis der Fall gelöscht wird |
| Prüfen und Korrigieren | Bauen Sie selbst | Bauen Sie selbst | Sie wählen, was geschwärzt wird | Eingebaut |
| Dateien | Text; Bilder über das OCR-Modul | Google: Text und Bilder. Amazon: reiner Text | PDF einschließlich Scans, DOCX, XLSX, PPTX, HTML, TXT, EML und mehr | |
| Gemacht für | Entwickler | Entwickler und IT-Teams | Alle, die PDFs weitergeben | Büroanwender unter Windows |
| Preis | Kostenlos, plus Arbeitszeit | Nach Volumen | Acrobat-Pro-Abo | Einmalig 19,99 $ in den USA, 7 Tage Testversion |
So wählen Sie aus
- Sie verarbeiten Tausende Datensätze in einer Datenbank oder Verarbeitungskette und haben Entwickler: eine Bibliothek oder ein Cloud-Dienst.
- Sie senden ein Dokument an jemanden außerhalb der Kanzlei: Schwärzung.
- Sie befragen eine KI zu Mandantendokumenten und brauchen die Namen in der Antwort zurück: eine Desktop-App mit Prüfschritt und einer Möglichkeit, Namen wiederherzustellen.
Bevor Sie sich festlegen, testen Sie das Tool an drei Dokumenten, die Sie gut kennen, in jeder Sprache, die Sie nutzen, und zählen Sie, was es übersehen hat. Hat Ihre Kanzlei einen Datenschutzbeauftragten oder eine Compliance-Verantwortliche, beziehen Sie sie ein, bevor das Tool für Mandantendateien eingesetzt wird.
Häufige Fragen
Darf ich ein pseudonymisiertes Dokument an jedes KI-Tool senden?
Nicht automatisch. Nach der DSGVO sind es weiterhin personenbezogene Daten, und die Datenschutzeinstellungen und Bedingungen des KI-Tools spielen weiter eine Rolle. Pseudonymisierung senkt das Risiko. Sie beseitigt es nicht.
Kann eine kostenlose Open-Source-Bibliothek ein kostenpflichtiges Tool ersetzen?
Ja, wenn jemand in Ihrem Team sie installieren, den Code darum herum schreiben und sie pflegen kann. Kann das niemand, kostet die Bibliothek mehr Zeit als eine App Geld.
Brauche ich Umkehrbarkeit, wenn ich nur eine Zusammenfassung will?
Wenn die Zusammenfassung Personen erwähnt, ja: Sie werden deren Namen darin zurückhaben wollen. Wenn nicht, genügt ein Ersetzen in eine Richtung.
Wie teste ich ein Tool schnell?
Nehmen Sie ein Dokument, in dem Sie jeden Namen und jede Nummer kennen. Lassen Sie es durch das Tool laufen und vergleichen Sie. Prüfen Sie die gescannten Seiten, die Kopfzeilen und die Unterschriften, wo die Erkennung am häufigsten etwas übersieht.
ClientSafe ersetzt auf Ihrem PC Namen, Adressen, Telefonnummern und Ausweisnummern durch einheitliche Platzhalter, lässt Sie die Liste prüfen und setzt die echten Namen wieder in die Antwort der KI ein. Die Erkennung ist nicht perfekt, prüfen Sie die Liste also, bevor Sie kopieren.