Si quieres usar la IA con documentos que contienen datos personales, una herramienta de seudonimización tiene que acertar en cuatro cosas. Tu archivo se procesa en un sitio que te parece aceptable. Cada persona recibe el mismo marcador en todos los documentos. La clave que deshace el cambio se guarda de forma segura. Y puedes revisar y corregir lo que encontró la herramienta. El resto de esta lista te dice si una herramienta encaja con tus documentos, tu equipo y tu presupuesto.
Lo que tiene que hacer la herramienta
Según el RGPD, la seudonimización es el tratamiento de datos personales de manera que ya no puedan atribuirse a una persona sin información adicional, siempre que esa información figure por separado y esté protegida (artículo 4, punto 5). Los datos seudonimizados siguen siendo datos personales. Lo que eso significa para los chatbots de IA se explica en el RGPD y los datos seudonimizados en la IA.
Para trabajar con IA, el proceso es este. Los nombres, las direcciones y los números se convierten en marcadores como Person_1. La IA trabaja con los marcadores. En tu lado, una clave los vuelve a convertir en nombres en la respuesta. Si nunca necesitas recuperar los nombres, quizá te convenga más la anonimización o el tachado: consulta cuál de las tres necesitas.
Adónde van tus datos
- Dónde se hace el procesamiento. O en tu ordenador, o en los servidores del proveedor después de subir el archivo. En el segundo caso, el original, con todos los nombres, llega a un tercero antes de estar protegido. Nuestra comparación de herramientas locales y en línea recoge las preguntas que hay que hacer a un proveedor en línea y una prueba sencilla para una aplicación de escritorio: desconecta la red y pruébala.
- Qué pasa después con los datos. En un servicio en la nube: cuánto tiempo se guardan los archivos y los resultados, en qué región y quiénes son los subencargados. En una aplicación de escritorio: qué escribe en tu disco y cómo se borra.
- Registros. Un registro de cuándo se procesaron los documentos es útil cuando lo pide un cliente o tu delegado de protección de datos. Comprueba que el propio registro no contenga los datos personales.
Si puedes recuperar los nombres
- Coherencia. La misma persona debe recibir el mismo marcador en cada párrafo y en cada documento de un mismo asunto. Si no, la IA no puede saber que el inquilino del contrato y el remitente del correo son la misma persona. Pregunta cómo trata la herramienta variantes como «María López», «Sra. López» y «M. López».
- Reversibilidad. Algunas herramientas sustituyen los datos solo en un sentido. Otras guardan una tabla que vincula los marcadores con los nombres reales, o cifran los valores con una clave que puede descifrarlos después.
- Dónde se guarda la clave. La tabla o la clave es la «información adicional» de la que habla la definición del RGPD. Pregunta dónde se guarda, si está cifrada, quién puede abrirla y cuándo se borra. Si cualquiera que tenga la copia segura puede leer también la clave, la seudonimización protege poco.
Si encaja con tus documentos
- Tipos de datos que encuentra. Nombres, empresas, direcciones, teléfonos, correos electrónicos, números de cuenta y de identificación, fechas de nacimiento. Si trabajas con varios países, comprueba los números de identidad y fiscales de los países con los que tratas. Los cargos, los apodos y los detalles poco comunes son difíciles para cualquier detector, así que marcarás algunos a mano.
- Un paso de revisión. La detección nunca es completa. Incluso la documentación de Presidio, un detector de código abierto muy usado, dice que no hay garantía de que encuentre toda la información sensible. Necesitas ver cada coincidencia, desmarcar las falsas y añadir lo que se pasó por alto antes de que salga nada.
- Formatos de archivo. PDF, Word, Excel, correos. Los PDF escaneados y las fotos de documentos necesitan reconocimiento de texto. Algunas herramientas solo aceptan texto plano, lo que significa que conviertes tú cada archivo.
- Idiomas. La detección depende del idioma. Prueba con documentos reales en cada idioma con el que trabajas.
Para quién está hecha y cuánto cuesta
- Desarrolladores o usuarios de oficina. Una biblioteca o una API necesita a alguien que la instale, escriba código a su alrededor y la mantenga en marcha. Una aplicación de escritorio solo hay que instalarla. Están hechas para personas distintas, y ninguna es mejor en general.
- Modelo de precios. Pago por volumen (por gigabyte o por cada cien caracteres), suscripción por usuario, pago único, o código abierto gratuito más el tiempo de tu personal. Calcula el coste anual con el volumen que de verdad esperas.
Cuatro tipos de herramientas
Los ejemplos de abajo son los que pudimos contrastar con la documentación de los proveedores. Funciones y precios a octubre de 2026.
Bibliotecas de código abierto para desarrolladores
Presidio es un framework con licencia MIT para encontrar y desidentificar datos personales. Nació en Microsoft y ahora es un proyecto gestionado por la comunidad dentro de la organización Data Privacy Stack. Su anonimizador puede sustituir, tachar, enmascarar, aplicar hash o cifrar cada elemento que encuentra, y los valores cifrados se pueden descifrar con la misma clave. Un módulo aparte encuentra y tacha texto en imágenes mediante OCR.
Es gratuito, funciona en tus propias máquinas y se puede adaptar a casi cualquier flujo de trabajo. Es un kit de herramientas más que una aplicación: la instalación implica paquetes de Python, descargar un modelo de lenguaje y código que escribes tú. Las pantallas de revisión, la gestión de casos y la conversión de archivos te tocan a ti.
Servicios de protección de datos en la nube
Google Cloud Sensitive Data Protection encuentra datos sensibles con una larga lista de detectores integrados y puede sustituirlos por tokens. El cifrado determinista y el cifrado que conserva el formato dan el mismo token para el mismo valor, y los datos se pueden reidentificar con la clave. Google recomienda proteger esa clave con Cloud Key Management Service. El servicio también puede tachar imágenes tapando lo que encuentra con recuadros opacos. Su precio es por gigabyte.
Amazon Comprehend detecta datos personales en textos en inglés o en español. El tachado se ejecuta como un trabajo por lotes sobre archivos de Amazon S3 y sustituye cada elemento por su tipo, como [NAME], o por un carácter de máscara, de modo que dos personas distintas acaban siendo [NAME]. Su precio va por unidades de 100 caracteres.
Estos servicios manejan grandes volúmenes y se integran en el resto de la infraestructura en la nube de una empresa, con la cuenta y el contrato de la propia empresa. Están hechos para desarrolladores y equipos de TI.
Tachado en editores de PDF
En Adobe Acrobat Pro, el tachado sustituye texto o imágenes por recuadros de color y no se puede deshacer una vez guardado. Un paso aparte, Sanitize, quita datos ocultos como los metadatos. Es la herramienta adecuada para un documento que entregas a un tribunal, a la otra parte o a un regulador. Para ir y volver de la IA no sirve: los recuadros negros no le dicen a la IA quién es quién, y no hay nada que revertir. Consulta marcadores frente a barras negras.
Aplicaciones de escritorio para usuarios de oficina
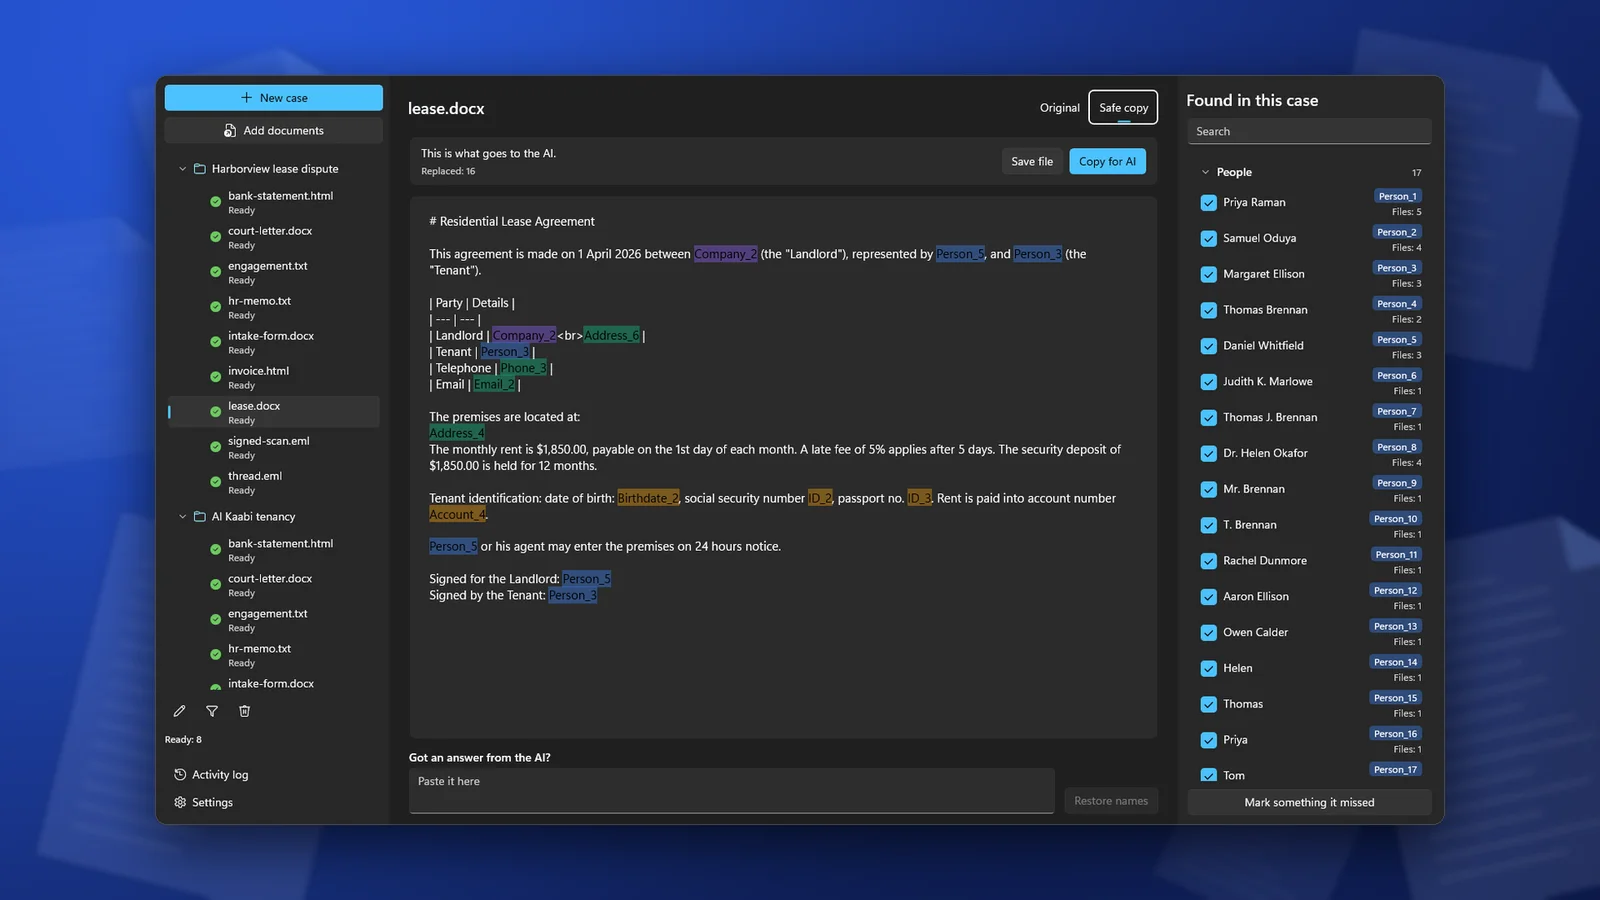
ClientSafe es una de ellas. Funciona en un PC con Windows y organiza los documentos en casos, así que un mismo nombre recibe el mismo marcador en todos los documentos de un caso. Revisas lo que encontró, desmarcas las coincidencias que no son datos personales y marcas lo que se le pasó. Copias la copia segura en un chat de IA o la guardas como archivo Markdown. Después pegas la respuesta de la IA y ClientSafe vuelve a poner los nombres reales. La tabla que vincula los marcadores con los nombres se guarda cifrada en el PC hasta que eliminas el caso. No es una herramienta para tachar datos en escritos judiciales ni en documentos que envías a otra parte.
Comparación
| Criterio | Biblioteca para desarrolladores (Presidio) | Servicio en la nube (Google, Amazon) | Tachado de PDF (Acrobat Pro) | Aplicación de escritorio (ClientSafe) |
|---|---|---|---|---|
| Dónde funciona | En tus propias máquinas | En la nube del proveedor, con tu cuenta | En el editor de PDF | En tu PC |
| Mismo marcador para la misma persona | Si lo configuras | Google: con cifrado determinista. Tachado de Amazon: solo etiquetas de tipo | No, recuadros negros | Sí, dentro de un caso |
| Reversible | Con cifrado o con tu propia tabla de correspondencias | Google: con la clave. Tachado de Amazon: no | No, por diseño | Sí, pegando la respuesta |
| Dónde está la clave | Donde la ponga tu código | Google recomienda Cloud KMS | No hay clave | Cifrada en tu PC hasta que se elimina el caso |
| Revisión y corrección | La desarrollas tú | La desarrollas tú | Tú eliges qué tachar | Incluida |
| Archivos | Texto; imágenes mediante el módulo de OCR | Google: texto e imágenes. Amazon: texto plano | PDF, incluidos escaneos, DOCX, XLSX, PPTX, HTML, TXT, EML y más | |
| Hecha para | Desarrolladores | Desarrolladores y equipos de TI | Cualquiera que comparta PDF | Usuarios de oficina con Windows |
| Precio | Gratis, más el tiempo del personal | Por volumen | Plan de Acrobat Pro | Pago único de 19,99 USD en EE. UU., 7 días de prueba |
Cómo elegir
- Procesas miles de registros en una base de datos o un flujo automatizado y tienes desarrolladores: una biblioteca o un servicio en la nube.
- Envías un documento a alguien de fuera de la empresa: tachado.
- Le preguntas a la IA por documentos de clientes y necesitas recuperar los nombres en la respuesta: una aplicación de escritorio con un paso de revisión y una forma de restaurar los nombres.
Antes de decidirte, prueba la herramienta con tres documentos que conozcas bien, en cada idioma que uses, y cuenta lo que se le pasó. Si tu empresa tiene un delegado de protección de datos o un responsable de cumplimiento, cuenta con ellos antes de usar la herramienta con archivos de clientes.
Preguntas frecuentes
Una vez seudonimizado un documento, ¿puedo enviarlo a cualquier herramienta de IA?
No automáticamente. Según el RGPD siguen siendo datos personales, y los ajustes de datos y los términos de la propia herramienta de IA siguen importando. La seudonimización reduce el riesgo. No lo elimina.
¿Puede una biblioteca gratuita de código abierto sustituir a una herramienta de pago?
Sí, si alguien de tu equipo puede instalarla, escribir el código a su alrededor y mantenerla. Si nadie puede, la biblioteca cuesta más en tiempo de lo que cuesta una aplicación en dinero.
¿Necesito reversibilidad si solo quiero un resumen?
Si el resumen va a mencionar a personas, sí: querrás recuperar sus nombres. Si no, basta con una sustitución en un solo sentido.
¿Cómo pruebo una herramienta rápidamente?
Toma un documento del que conozcas cada nombre y cada número. Pásalo por la herramienta y compara. Revisa las páginas escaneadas, los encabezados y las firmas, donde la detección falla más a menudo.
ClientSafe sustituye en tu PC los nombres, direcciones, teléfonos y números de identificación por marcadores coherentes, te deja revisar la lista y devuelve los nombres reales a la respuesta de la IA. La detección no es perfecta, así que revisa la lista antes de copiar.