Si vous voulez utiliser l’IA sur des documents contenant des données personnelles, un outil de pseudonymisation doit réussir quatre choses. Votre fichier est traité à un endroit qui vous convient. Chaque personne reçoit le même marqueur dans tous les documents. La clé qui permet d’inverser le remplacement est stockée en sécurité. Et vous pouvez vérifier et corriger ce que l’outil a trouvé. Le reste de cette liste vous dit si un outil convient à vos documents, à votre équipe et à votre budget.
Ce que l’outil doit faire
Au sens du RGPD, la pseudonymisation est un traitement de données personnelles réalisé de façon qu’elles ne puissent plus être attribuées à une personne sans recourir à des informations supplémentaires, conservées séparément et protégées (article 4, point 5). Les données pseudonymisées restent des données personnelles. Ce que cela implique pour les chatbots d’IA est traité dans le RGPD et les données pseudonymisées dans l’IA.
Pour le travail avec l’IA, la tâche se présente ainsi. Les noms, adresses et numéros deviennent des marqueurs tels que Person_1. L’IA travaille sur les marqueurs. De votre côté, une clé les retransforme en noms dans la réponse. Si vous n’avez jamais besoin de retrouver les noms, il vous faut peut-être plutôt l’anonymisation ou le caviardage : voir laquelle des trois méthodes il vous faut.
Où vont vos données
- Où le traitement a lieu. Soit sur votre ordinateur, soit sur les serveurs de l’éditeur après l’envoi du fichier. Dans le second cas, l’original, avec tous ses noms, parvient à un tiers avant d’être protégé. Notre comparaison des outils locaux et en ligne liste les questions à poser à un éditeur en ligne et un test simple pour une application de bureau : coupez le réseau et essayez-la.
- Ce que deviennent les données ensuite. Pour un service cloud : combien de temps les fichiers et les résultats sont conservés, dans quelle région, et qui sont les sous-traitants ultérieurs. Pour une application de bureau : ce qu’elle écrit sur votre disque et comment le supprimer.
- Journaux. Un relevé indiquant quand les documents ont été traités est utile quand un client ou votre délégué à la protection des données pose la question. Vérifiez que le journal lui-même ne contient pas les données personnelles.
Pouvez-vous retrouver les noms ?
- Cohérence. Une même personne doit recevoir le même marqueur dans chaque paragraphe et dans chaque document d’une même affaire. Sinon, l’IA ne peut pas savoir que le locataire du bail et l’expéditeur de l’e-mail sont une seule et même personne. Demandez comment l’outil traite des variantes comme « Maria Lopez », « Mme Lopez » et « M. Lopez ».
- Réversibilité. Certains outils remplacent les données dans un seul sens. D’autres conservent une table qui relie les marqueurs aux vrais noms, ou chiffrent les valeurs avec une clé qui permet de les déchiffrer plus tard.
- Où la clé est conservée. La table ou la clé, ce sont les « informations supplémentaires » dont parle la définition du RGPD. Demandez où elle est stockée, si elle est chiffrée, qui peut l’ouvrir et quand elle est supprimée. Si quiconque détient la copie sûre peut aussi lire la clé, la pseudonymisation protège peu.
Convient-il à vos documents ?
- Types de données détectés. Noms, sociétés, adresses, numéros de téléphone, adresses e-mail, numéros de compte et d’identification, dates de naissance. Si vous travaillez à l’international, vérifiez les numéros d’identité et fiscaux des pays concernés. Les fonctions, les surnoms et les détails rares sont difficiles pour n’importe quel détecteur ; vous en marquerez certains à la main.
- Une étape de vérification. La détection n’est jamais complète. Même la documentation de Presidio, un détecteur open source très utilisé, indique qu’il n’y a aucune garantie qu’il trouve toutes les informations sensibles. Vous devez voir chaque correspondance, décocher les fausses et ajouter ce qui a été oublié avant que quoi que ce soit ne parte.
- Formats de fichiers. PDF, Word, Excel, e-mails. Les PDF numérisés et les photos de documents nécessitent une reconnaissance de texte. Certains outils n’acceptent que du texte brut, ce qui veut dire que vous convertissez vous-même chaque fichier.
- Langues. La détection dépend de la langue. Testez avec de vrais documents dans chaque langue dans laquelle vous travaillez.
À qui il s’adresse et combien il coûte
- Développeurs ou utilisateurs de bureautique. Une bibliothèque ou une API exige quelqu’un pour l’installer, écrire le code autour et la maintenir. Une application de bureau n’a qu’à être installée. Elles s’adressent à des publics différents, et aucune n’est meilleure en général.
- Modèle de prix. Paiement au volume (par gigaoctet ou par centaine de caractères), abonnement par utilisateur, achat unique, ou open source gratuit plus le temps de votre personnel. Calculez le coût annuel au volume que vous prévoyez réellement.
Quatre types d’outils
Les exemples ci-dessous sont ceux que nous avons pu vérifier dans la documentation des éditeurs. Fonctions et prix en octobre 2026.
Bibliothèques open source pour développeurs
Presidio est un framework sous licence MIT qui sert à trouver et à désidentifier des données personnelles. Né chez Microsoft, il est désormais un projet communautaire au sein de l’organisation Data Privacy Stack. Son module d’anonymisation peut remplacer, caviarder, masquer, hacher ou chiffrer chaque élément trouvé, et les valeurs chiffrées peuvent être déchiffrées avec la même clé. Un module distinct repère et caviarde le texte dans les images grâce à l’OCR.
Il est gratuit, tourne sur vos propres machines et s’adapte à presque n’importe quelle chaîne de traitement. C’est une boîte à outils plutôt qu’une application : l’installation suppose des paquets Python, le téléchargement d’un modèle de langue et du code que vous écrivez vous-même. Écrans de vérification, gestion des dossiers et conversion des fichiers sont à développer par vos soins.
Services cloud de protection des données
Google Cloud Sensitive Data Protection détecte les données sensibles grâce à une longue liste de détecteurs intégrés et peut les remplacer par des jetons. Le chiffrement déterministe et le chiffrement préservant le format donnent le même jeton pour la même valeur, et les données peuvent être réidentifiées avec la clé. Google recommande d’encapsuler cette clé avec Cloud Key Management Service. Le service peut aussi caviarder des images en recouvrant les éléments trouvés de rectangles opaques. Il est facturé au gigaoctet.
Amazon Comprehend détecte les données personnelles dans les textes en anglais ou en espagnol. Le caviardage s’exécute en tâche par lots sur des fichiers stockés dans Amazon S3 et remplace chaque élément par son type, comme [NAME], ou par un caractère de masquage : deux personnes différentes deviennent donc toutes deux [NAME]. Il est facturé par unités de 100 caractères.
Ces services traitent de gros volumes et s’intègrent au reste de l’infrastructure cloud d’une entreprise, sous son propre compte et son propre contrat. Ils s’adressent aux développeurs et aux équipes informatiques.
Caviardage dans les éditeurs de PDF
Dans Adobe Acrobat Pro, le caviardage remplace du texte ou des images par des rectangles de couleur et ne peut pas être annulé une fois le fichier enregistré. Une étape distincte, « Sanitize », supprime les données masquées comme les métadonnées. C’est le bon outil pour un document que vous remettez à un tribunal, à une contrepartie ou à un régulateur. Pour un aller-retour avec une IA, il ne convient pas : les rectangles noirs n’indiquent pas à l’IA qui est qui, et il n’y a rien à inverser. Voir marqueurs ou bandes noires.
Applications de bureau pour les utilisateurs de bureautique
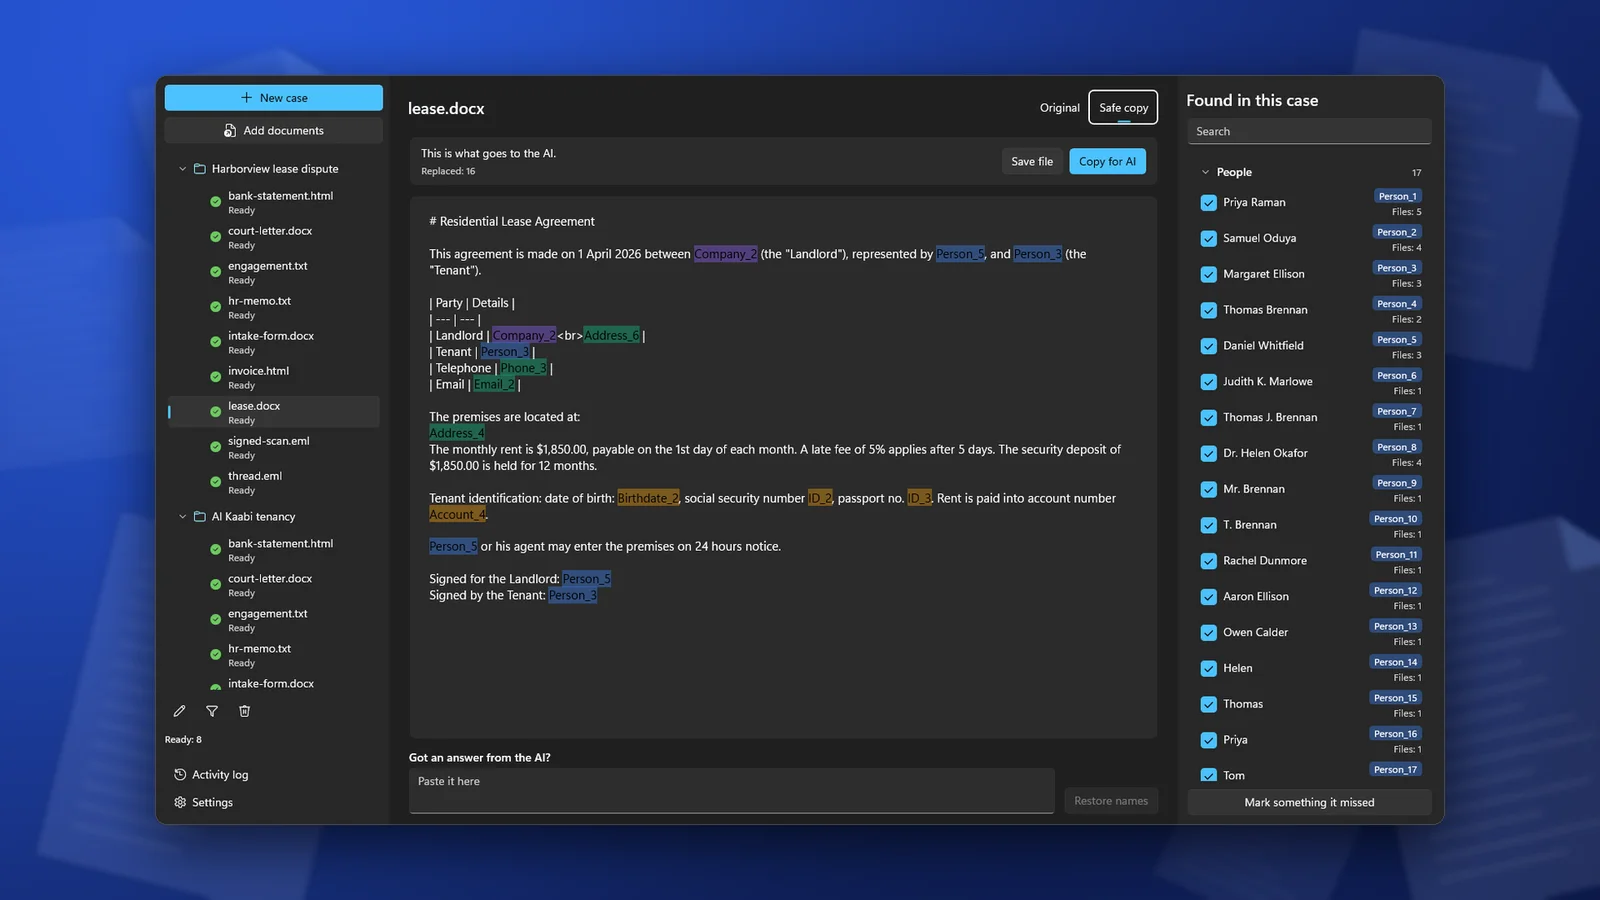
ClientSafe en fait partie. Il fonctionne sur un PC Windows et range les documents dans des dossiers, de sorte qu’un même nom reçoit le même marqueur dans tous les documents d’un dossier. Vous vérifiez ce qu’il a trouvé, décochez les correspondances qui ne sont pas des données personnelles et marquez ce qui a été oublié. Vous copiez la copie sûre dans une conversation avec une IA ou l’enregistrez dans un fichier Markdown. Vous collez ensuite la réponse de l’IA et ClientSafe y remet les vrais noms. La table qui relie les marqueurs aux noms reste chiffrée sur le PC jusqu’à ce que vous supprimiez le dossier. Ce n’est pas un outil de caviardage pour les actes judiciaires ni pour les documents que vous transmettez à une autre partie.
Côte à côte
| Critère | Bibliothèque pour développeurs (Presidio) | Service cloud (Google, Amazon) | Caviardage PDF (Acrobat Pro) | Application de bureau (ClientSafe) |
|---|---|---|---|---|
| Où il s’exécute | Vos propres machines | Le cloud du fournisseur, sous votre compte | Dans l’éditeur de PDF | Votre PC |
| Même marqueur pour la même personne | Si vous le configurez | Google : avec le chiffrement déterministe. Caviardage Amazon : étiquettes de type uniquement | Non, rectangles noirs | Oui, au sein d’un dossier |
| Réversible | Avec le chiffrement ou votre propre table de correspondance | Google : avec la clé. Caviardage Amazon : non | Non, par conception | Oui, en collant la réponse |
| Où se trouve la clé | Là où votre code la place | Google recommande Cloud KMS | Pas de clé | Chiffrée sur votre PC jusqu’à la suppression du dossier |
| Vérification et correction | À développer | À développer | Vous choisissez ce que vous caviardez | Intégrées |
| Fichiers | Texte ; images via le module OCR | Google : texte et images. Amazon : texte brut | PDF y compris numérisés, DOCX, XLSX, PPTX, HTML, TXT, EML et plus encore | |
| S’adresse à | Développeurs | Développeurs et équipes informatiques | Toute personne qui partage des PDF | Utilisateurs de bureautique sous Windows |
| Prix | Gratuit, plus le temps du personnel | Au volume | Abonnement Acrobat Pro | Achat unique de 19,99 $ aux États-Unis, 7 jours d’essai |
Comment choisir
- Vous traitez des milliers d’enregistrements dans une base de données ou une chaîne de traitement et vous avez des développeurs : une bibliothèque ou un service cloud.
- Vous envoyez un document à quelqu’un d’extérieur au cabinet : le caviardage.
- Vous interrogez une IA sur des documents clients et avez besoin de retrouver les noms dans la réponse : une application de bureau avec une étape de vérification et un moyen de restaurer les noms.
Avant de vous engager, essayez l’outil sur trois documents que vous connaissez bien, dans chaque langue que vous utilisez, et comptez ce qu’il a manqué. Si votre cabinet a un délégué à la protection des données ou un responsable de la conformité, associez-le avant d’utiliser l’outil sur des fichiers clients.
Questions fréquentes
Une fois un document pseudonymisé, puis-je l’envoyer à n’importe quel outil d’IA ?
Pas automatiquement. Au sens du RGPD, il s’agit toujours de données personnelles, et les réglages de données et les conditions de l’outil d’IA comptent toujours. La pseudonymisation réduit le risque. Elle ne le supprime pas.
Une bibliothèque open source gratuite peut-elle remplacer un outil payant ?
Oui, si quelqu’un dans votre équipe peut l’installer, écrire le code autour et la maintenir. Sinon, la bibliothèque coûte plus en temps qu’une application ne coûte en argent.
Ai-je besoin de la réversibilité si je veux seulement un résumé ?
Si le résumé mentionne des personnes, oui : vous voudrez y retrouver leurs noms. Sinon, un remplacement à sens unique suffit.
Comment tester rapidement un outil ?
Prenez un document dont vous connaissez chaque nom et chaque numéro. Passez-le dans l’outil et comparez. Vérifiez les pages numérisées, les en-têtes et les signatures, là où la détection échoue le plus souvent.
ClientSafe remplace sur votre PC les noms, adresses, numéros de téléphone et numéros d’identification par des marqueurs cohérents, vous laisse vérifier la liste, et remet les vrais noms dans la réponse de l’IA. La détection n’est pas parfaite : vérifiez la liste avant de copier.