PDFと照合してから、Markdownのコピーで繰り返しヘッダーとフッターを削除します。意味や出典に関わる情報は残してください。
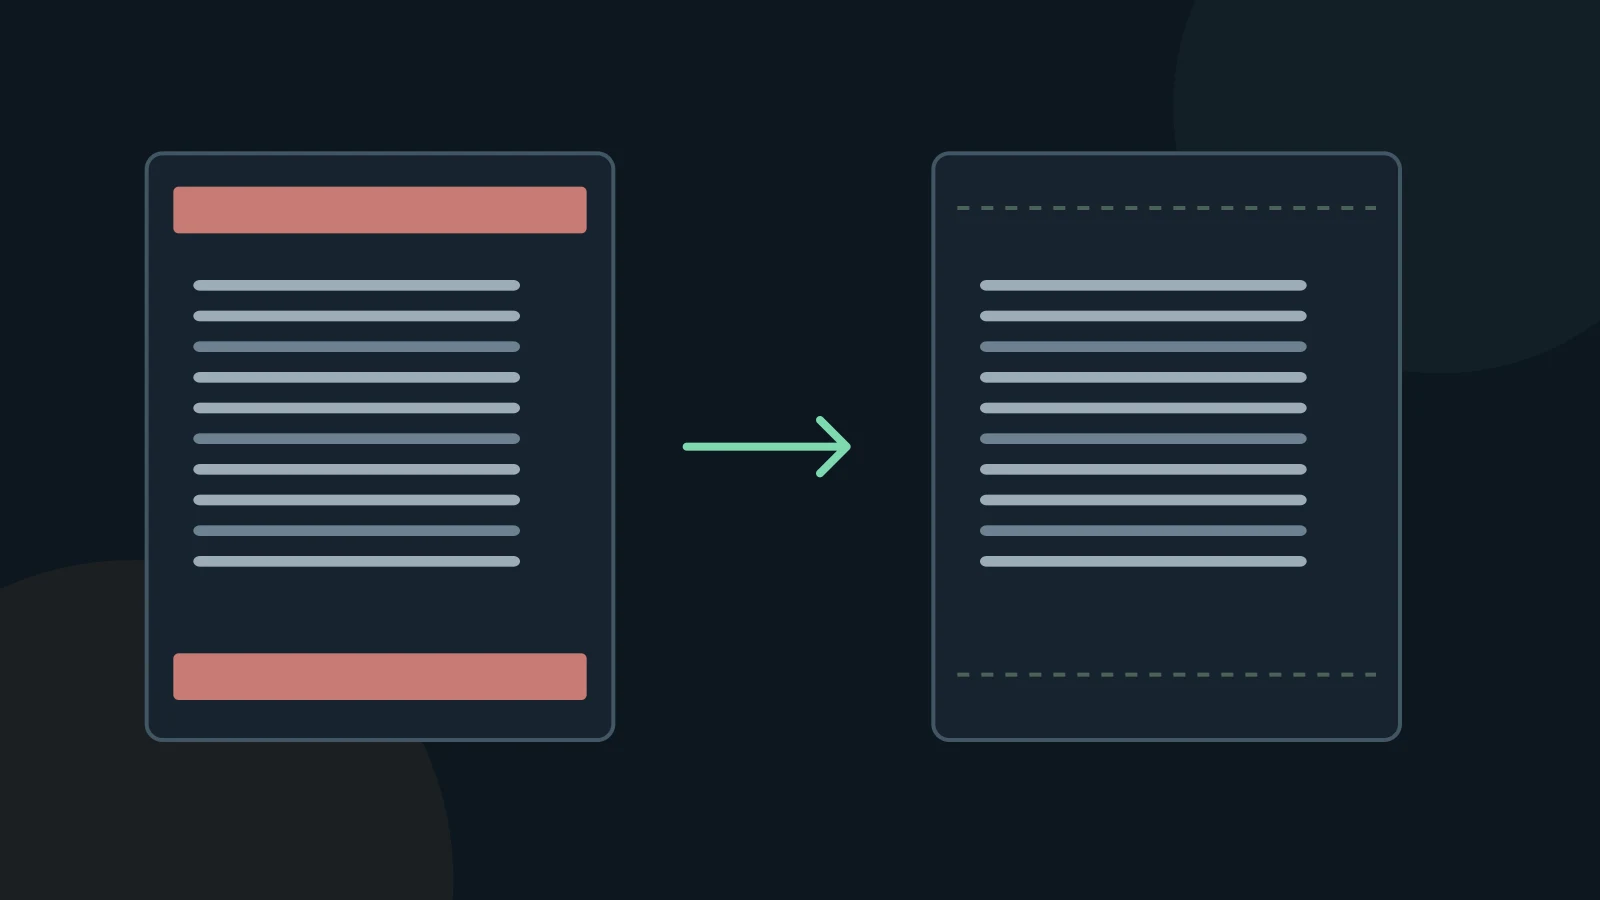
ページの装飾と内容を分ける
毎ページの報告書名が抽出後に段落を分断することがあります。ページ番号、著作権表示、節名はそれぞれ判断が必要です。長い表の繰り返し見出しは読み手に役立ち、柱と同じ削除規則にはできません。
pypdfは座標による除外例を示す一方、複雑な文書では位置の判断が難しいと注意しています。上下の固定領域を一律に削ると、脚注や段落の最終行まで失うおそれがあります。
確認できたパターンだけを消す
- 元の出力を保存します。特徴的な語句を検索し、最初、中間、最後の出現を調べます。
- PDFのページ端と比較します。表紙や向きの違うページは別に確認します。
- 確認済みの繰り返し行だけを削除します。変わるページ番号は個別か対象を絞った規則で確認します。
- 影響した段落のつなぎ目を読み、差分比較で本文の誤削除がないか確かめます。
出典と重要な注記を残す
「年次報告書」が各ページで文の途中に入るなら、その重複を除きます。文書見出しや出典注記には一度残します。変わる章名は、その章の冒頭で本来の見出しとして使える場合があります。
短い行や数字を含む行を全部消してはいけません。日付、参照、表の値、脚注も該当します。適用される機密表示や利用制限は出典注記に残します。文章の整理で共有権限は変わりません。
使う前に結果を確認する
変換結果は作業用のコピーです。元のPDFを残し、引用、計算、AIへの入力に使う箇所を照合してください。書き出しが成功しても、内容の完全性や正確性が確認されたわけではありません。
MD FactoryはWindowsで文書をMarkdownに変換します。複雑なPDF表には配置に基づく推定を使うため、結合セルや複数行のセルは手直しが必要になることがあります。OCRの精度は元の画像と文字によって異なります。このガイドは自動清掃や特定の認識精度を保証しません。
よくある質問
ページ番号は必ず削除しますか?
いいえ。引用や再確認に役立ちます。有用な参照は文中から取り出し、統一した目印にします。
整理すればAIの回答は正確になりますか?
入力は読みやすくなりますが、回答は引き続き出典との照合が必要です。
出典と確認
出典確認日:2026年11月3日。ここで説明するのは手動の確認作業であり、MD Factoryの追加操作機能ではありません。