Retirez les en-têtes et pieds répétés d’une copie du Markdown après comparaison avec le PDF. Conservez les éléments qui changent le sens ou identifient la source.
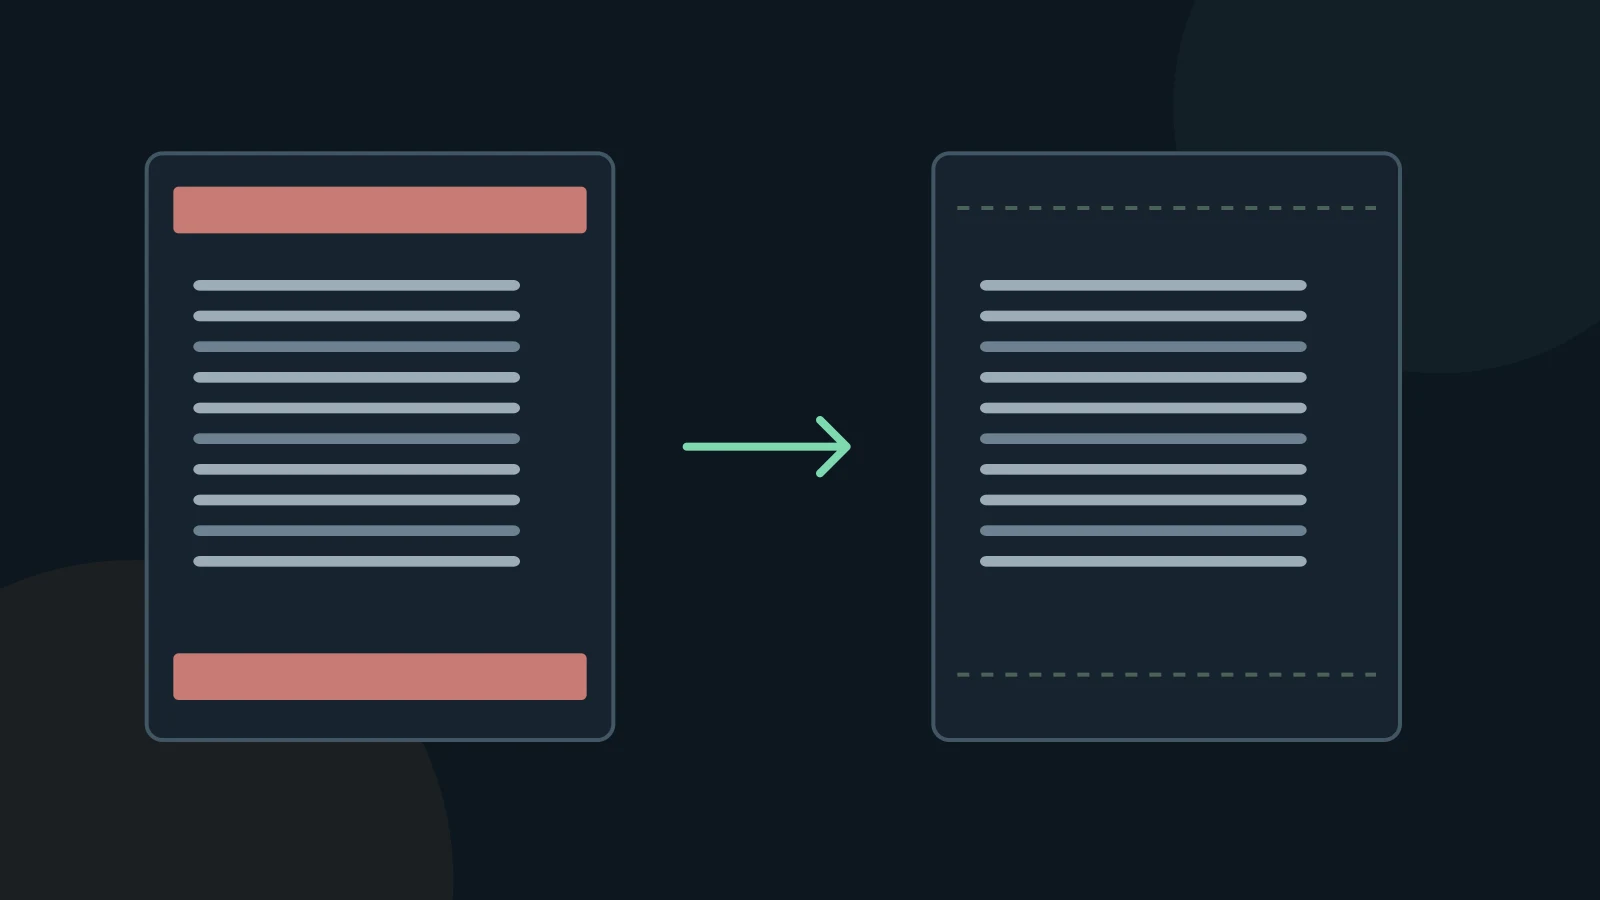
Distinguer habillage de page et contenu
Un titre de rapport répété peut interrompre les paragraphes extraits. Numéros de page, mentions de copyright et noms de section demandent des décisions distinctes. Un en-tête répété dans un long tableau reste utile et ne relève pas de la même règle.
pypdf présente un filtre par coordonnées, mais signale les difficultés de position dans les fichiers complexes. Des limites fixes en haut et en bas ne conviennent pas partout : une note ou une dernière ligne peut occuper ces zones.
Supprimer uniquement un motif confirmé
- Conservez l’export initial. Recherchez une expression distinctive et examinez ses occurrences au début, au milieu et à la fin.
- Comparez-les aux bords des pages PDF. Vérifiez séparément couvertures et pages d’orientation différente.
- Retirez seulement la ligne répétée confirmée. Contrôlez les numéros variables individuellement ou avec un motif strictement limité.
- Relisez chaque jonction de paragraphe touchée. Comparez les versions pour repérer du contenu supprimé à tort.
Préserver provenance et notes importantes
Si « Rapport annuel » coupe une phrase sur chaque page, retirez ces répétitions. Gardez le titre une fois dans l’en-tête du document ou la note de source. Un nom de chapitre variable peut devenir un vrai titre au début du chapitre.
Ne supprimez pas toutes les lignes courtes ou contenant des chiffres : dates, renvois, valeurs et notes seraient aussi touchés. Conservez les restrictions d’usage et mentions de confidentialité applicables. Nettoyer un texte ne change pas les autorisations de partage.
Vérifier le résultat avant utilisation
La conversion produit une copie de travail. Conservez le PDF original et comparez les passages à citer, à utiliser pour des calculs ou à transmettre à une IA. Un export réussi ne prouve ni l’exactitude ni l’exhaustivité du texte.
MD Factory convertit les documents en Markdown sous Windows. Les tableaux PDF complexes reposent sur des heuristiques de mise en page ; les cellules fusionnées et multilignes peuvent nécessiter une correction manuelle. La précision de l’OCR dépend de l’image et du texte sources. Ce guide ne promet ni nettoyage automatique ni taux de reconnaissance particulier.
Questions et réponses
Faut-il toujours supprimer les numéros de page ?
Non. Ils servent à citer et vérifier. Transformez les renvois utiles en repères cohérents hors des phrases.
Le nettoyage garantit-il une réponse IA exacte ?
Il facilite la lecture de l’entrée, mais la réponse reste à vérifier dans la source.
Sources et vérification
Sources consultées le 3 novembre 2026. Ces instructions décrivent une vérification manuelle, pas des commandes supplémentaires de MD Factory.