Удаляйте повторяющиеся колонтитулы из копии Markdown после сверки с PDF. Сохраняйте сведения, которые влияют на смысл или указывают происхождение документа.
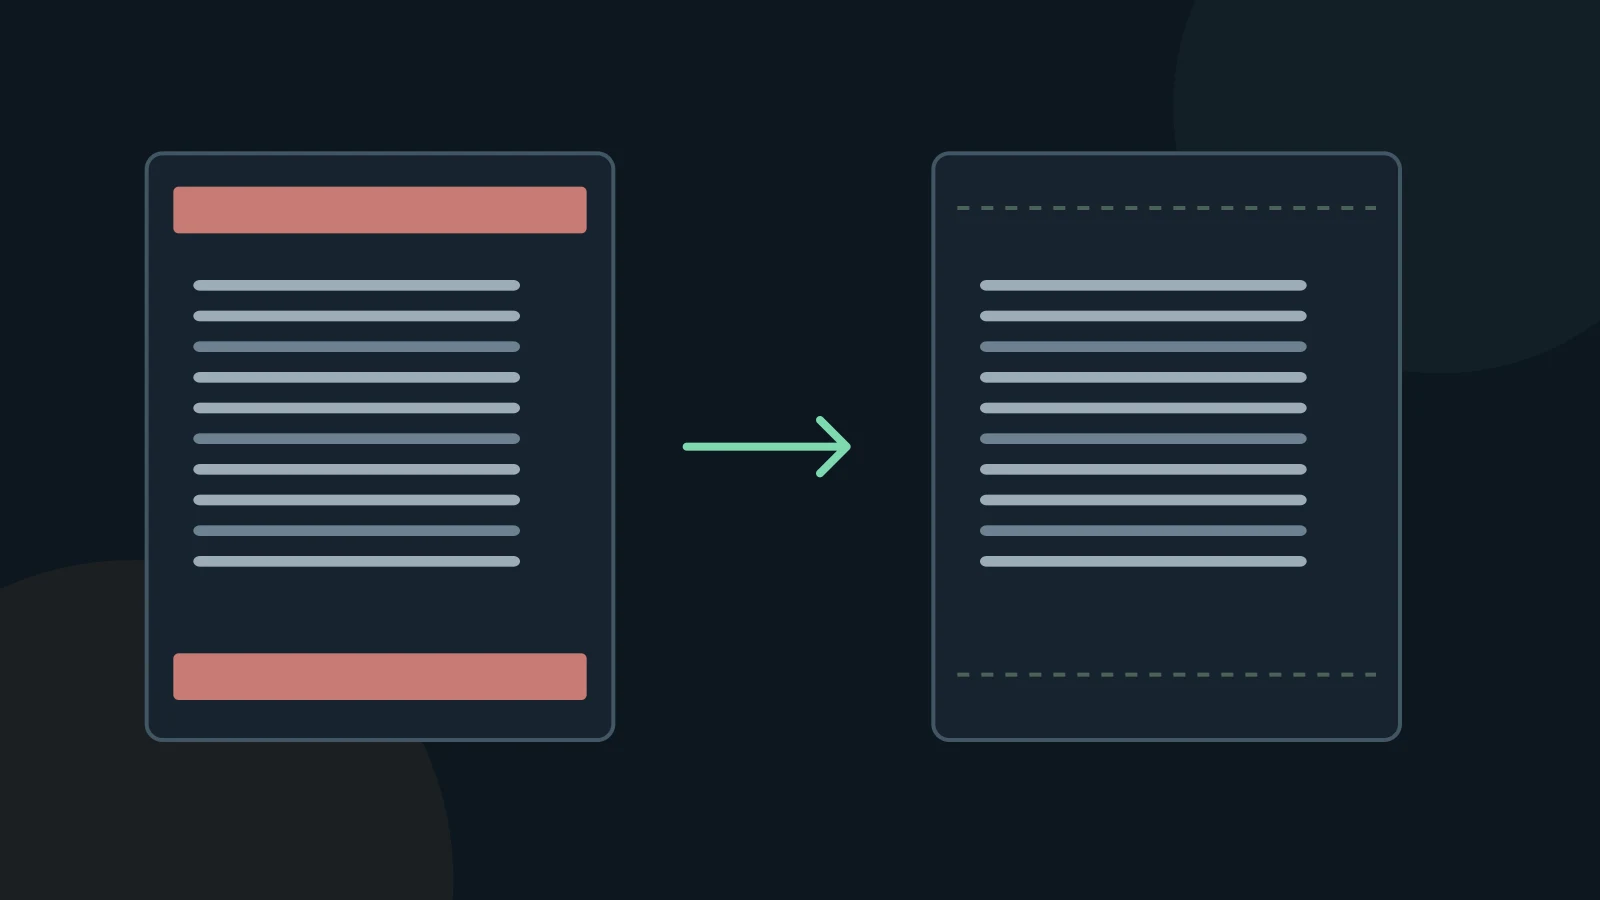
Отделите оформление страницы от содержания
Повторяющееся название отчёта может разрывать абзацы после извлечения. Номера страниц, строки copyright и названия разделов требуют разных решений. Повтор заголовка внутри длинной таблицы полезен; его нельзя удалять по правилу для колонтитулов.
pypdf показывает фильтр по координатам, но предупреждает о сложностях определения позиции в сложных файлах. Фиксированные границы сверху и снизу не универсальны: там могут находиться сноски и последние строки абзацев.
Удаляйте только подтверждённый шаблон
- Сохраните исходный экспорт. Найдите характерную фразу и проверьте вхождения в начале, середине и конце.
- Сравните их с краями страниц PDF. Отдельно проверьте обложки и страницы другой ориентации.
- Удалите только подтверждённую повторяющуюся строку. Меняющиеся номера проверяйте отдельно или по узкому шаблону.
- Перечитайте затронутые стыки абзацев. Сравните версии через diff, чтобы увидеть ошибочно удалённый основной текст.
Сохраните происхождение и значимые примечания
Если «Годовой отчёт» на каждой странице стоит между половинами предложения, удалите повторы. Название сохраните один раз в заголовке документа или сведениях об источнике. Меняющееся название главы может стать полноценным заголовком в начале главы.
Не удаляйте все короткие строки или все строки с числами: под правило попадут даты, ссылки, значения и сноски. Сохраните действующие ограничения использования и предупреждения о конфиденциальности в примечании. Очистка текста не меняет права на передачу документа.
Проверьте результат перед использованием
Конвертация создаёт рабочую копию. Сохраните исходный PDF и сравните с ним фрагменты для цитирования, расчётов и передачи ИИ. Успешный экспорт не подтверждает полноту и правильность текста.
MD Factory конвертирует документы в Markdown на Windows. Сложные таблицы PDF разбираются с помощью эвристик расположения; объединённые и многострочные ячейки могут потребовать ручной правки. Точность OCR зависит от исходного изображения и текста. Инструкция не обещает автоматическую очистку или определённую точность распознавания.
Вопросы и ответы
Нужно всегда убирать номера страниц?
Нет. Они помогают цитировать и проверять. Полезные ссылки оформите единообразными маркерами вне предложений.
Гарантирует ли очистка правильный ответ ИИ?
Она облегчает чтение входного текста. Ответ всё равно нужно сверять с источником.
Источники и проверка
Источники проверены 3 ноября 2026 года. Здесь описана ручная проверка, а не дополнительные элементы интерфейса MD Factory.