Masquer les données personnelles (PII) dans un prompt d’IA, c’est remplacer les informations qui identifient une personne (noms, coordonnées, numéros de compte et d’identification, dates de naissance) par des étiquettes neutres avant de coller le texte dans ChatGPT, Claude ou Gemini. Gardez les rôles, les montants et les dates des événements dont l’IA a besoin, masquez tout ce qui indique qui est la personne, et relisez le texte masqué une dernière fois avant de l’envoyer.
Ce que sont les PII, et en quoi elles diffèrent des données personnelles
PII signifie personally identifiable information, soit « informations permettant d’identifier une personne ». C’est un terme américain issu des lignes directrices fédérales. L’OMB Circular A-130 les définit comme des informations qui peuvent servir à distinguer ou retracer l’identité d’une personne, seules ou combinées à d’autres informations liées ou pouvant être liées à cette personne. Le NIST SP 800-122, le guide du NIST sur la protection de la confidentialité des PII, donne des exemples : nom, numéro de sécurité sociale, date et lieu de naissance, données biométriques, et informations liées à une personne comme des informations médicales, financières ou professionnelles.
L’UE et le Royaume-Uni emploient un autre terme. Selon l’article 4, point 1, du RGPD, et le même article du UK GDPR, une donnée à caractère personnel est « toute information se rapportant à une personne physique identifiée ou identifiable », y compris par des données de localisation, un identifiant en ligne, ou des éléments propres à son identité physique, économique, culturelle ou sociale.
Pour un prompt, la différence est surtout une question d’habitude. Ceux qui pensent « PII » cherchent des champs : nom, numéro de sécurité sociale, e-mail. La définition du RGPD oblige aussi à se demander si une phrase, lue avec le reste, désigne une seule personne. Si vos clients sont dans l’UE ou au Royaume-Uni, appliquez cette définition plus large. La licéité d’un usage donné de l’IA pour votre cabinet est une question pour votre avocat ou votre délégué à la protection des données, pas pour un outil de masquage.
Pourquoi des détails anodins s’additionnent
Les identifiants se répartissent en deux groupes. Les identifiants directs désignent à eux seuls une personne : un nom complet, un numéro de passeport, une adresse e-mail. Les quasi-identifiants, non, mais ils réduisent le champ : un code postal, une date de naissance, une fonction, un diagnostic rare.
La mesure la plus connue de la vitesse à laquelle ils le réduisent vient de Latanya Sweeney. À partir des données du recensement américain de 1990, elle a estimé dans « Simple Demographics Often Identify People Uniquely » que 87 % de la population américaine était probablement unique sur trois champs seulement : code postal ZIP à 5 chiffres, sexe et date de naissance. Une nouvelle analyse de Philippe Golle a ensuite ramené ce chiffre à environ 63 % pour le recensement de 2000. Dans les deux cas, trois faits ordinaires suffisaient à isoler la plupart des gens.
Dans un prompt, les quasi-identifiants se cachent généralement dans le texte libre : « la seule associée du bureau de Leeds », « le client qui a vendu la boulangerie de Main Street au printemps dernier ». Notre liste de ce qu’il faut retirer avant d’envoyer un document à l’IA passe en revue ces combinaisons, type par type.
Masquage, caviardage, pseudonymisation : ce que l’IA peut encore faire
Ces trois mots sont souvent employés sans rigueur. Pour un prompt, ce qui compte, c’est ce que chacun laisse à l’IA pour travailler. Prenons une phrase : « Anna Weber a écrit à Tom Hale le 3 mai ; Anna conteste la facture de Tom. »
| Méthode | La phrase devient | Ce que l’IA peut encore faire | Pouvez-vous restaurer les noms ? |
|---|---|---|---|
| Caviardage (supprimer ou noircir) | « [█████] a écrit à [█████] le 3 mai ; [█████] conteste la facture de [█████]. » | Peu de chose : elle ne sait pas qui a écrit, qui conteste et à qui l’argent est dû. | Non |
| Masquage par une étiquette de type | « [NAME] a écrit à [NAME] le 3 mai ; [NAME] conteste la facture de [NAME]. » | Elle sait qu’il s’agit de personnes, mais pas laquelle est laquelle. | Non |
| Pseudonymisation (marqueurs cohérents) | « Person_1 a écrit à Person_2 le 3 mai ; Person_1 conteste la facture de Person_2. » | Suivre qui a fait quoi et répondre dans les mêmes termes. | Oui, avec la table qui relie les marqueurs aux noms, conservée de votre côté |
Pour la plupart des tâches d’IA, des marqueurs cohérents donnent les meilleures réponses, parce que l’IA peut toujours suivre l’histoire. Le RGPD appelle cela la pseudonymisation (article 4, point 5) et considère toujours le résultat comme des données personnelles. Notre article sur l’anonymisation, la pseudonymisation et le caviardage explique les trois termes en détail.
Quoi masquer dans un prompt, et quoi garder
Masquez ce qui identifie la personne. Gardez ce sur quoi porte la question.
| À masquer | À garder |
|---|---|
| Noms de personnes et de sociétés, surnoms, initiales | Les rôles : acheteur, locataire, salarié, notre client, la partie adverse |
| Adresses e-mail, numéros de téléphone, adresses postales | Le pays ou la juridiction, si la réponse en dépend |
| Numéros de compte, IBAN, numéros de carte, numéros fiscaux et d’identification, numéros de dossier et de police | Les montants, sauf si le montant lui-même identifierait le client |
| Dates de naissance | Les dates des événements : signature, préavis, paiement, échéance |
| Les détails en texte libre qui isolent quelqu’un : une fonction rare, une petite ville, un proche nommé | Les faits dont dépend la question, formulés de façon générale |
L’âge est une exception fréquente à « masquer les dates de naissance » : si la réponse dépend du fait que quelqu’un a plus de 18 ans ou approche de la retraite, écrivez l’âge ou « plus de 65 ans » au lieu de la date.
Un prompt court, avant et après :
Avant :
Maria Lopez (née le 12 mars 1981, maria.lopez@example.com) loue
un appartement à Greenfield Lettings Ltd. Son dépôt de garantie de 2 400 $
ne lui a pas été rendu après son départ le 30 juin. Que peut-elle faire ?

Après :
Person_1 (née le Date_1, Email_1) loue un appartement à Company_1.
Le dépôt de garantie de 2 400 $ de Person_1 ne lui a pas été rendu après
son départ le 30 juin. Que peut faire Person_1 ? Garde les marqueurs tels quels.
Le montant et la date de départ restent, parce que la réponse en dépend. Si la date de naissance n’apporte rien à la question, supprimez-la au lieu de la masquer.
Trois façons de masquer
À la main
Pour un prompt court, lisez le texte et remplacez vous-même chaque identifiant. Notez la liste des marqueurs au fur et à mesure (Person_1 = Maria Lopez), pour que la même personne reçoive toujours la même étiquette. Le masquage manuel est lent, et il échoue sur les textes longs : un nom qui apparaît douze fois est remplacé onze fois.
Par rechercher-remplacer sur des motifs
Certains identifiants suivent un format fixe, et une recherche par expressions régulières les trouve tous d’un coup. Des éditeurs de texte comme Notepad++ et VS Code le permettent, et Word propose une recherche avec caractères génériques, qui a sa propre syntaxe. Deux motifs pour commencer :
Email:  [A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}
IBAN:   \b[A-Z]{2}[0-9]{2}(?: ?[A-Z0-9]){11,30}\b
Le motif IBAN suit la structure du SWIFT IBAN Registry : un code pays de deux lettres, deux chiffres de contrôle, puis jusqu’à trente lettres et chiffres. Les motifs repèrent des formats, pas du sens. Ils ratent un numéro de téléphone écrit en toutes lettres, et ne trouveront jamais un nom.
Avec un outil de détection
Les outils de détection cherchent les noms, les sociétés et les lieux en plus des motifs. Sur un long document, ils sont bien plus rapides que le travail manuel, mais aucun ne trouve tout. La documentation de la boîte à outils de détection open source Presidio le dit clairement : comme elle repose sur une détection automatisée, « rien ne garantit que Presidio trouvera toutes les informations sensibles ».
La détection exige donc une étape de vérification. Parcourez ce que l’outil a trouvé et décochez les fausses correspondances, comme un nom de rue qui est aussi un nom de famille. Lisez ensuite le texte pour repérer ce qu’il a manqué : surnoms, noms écrits en minuscules, personne décrite plutôt que nommée. Quoi vérifier dans un outil de pseudonymisation compare les types d’outils disponibles.
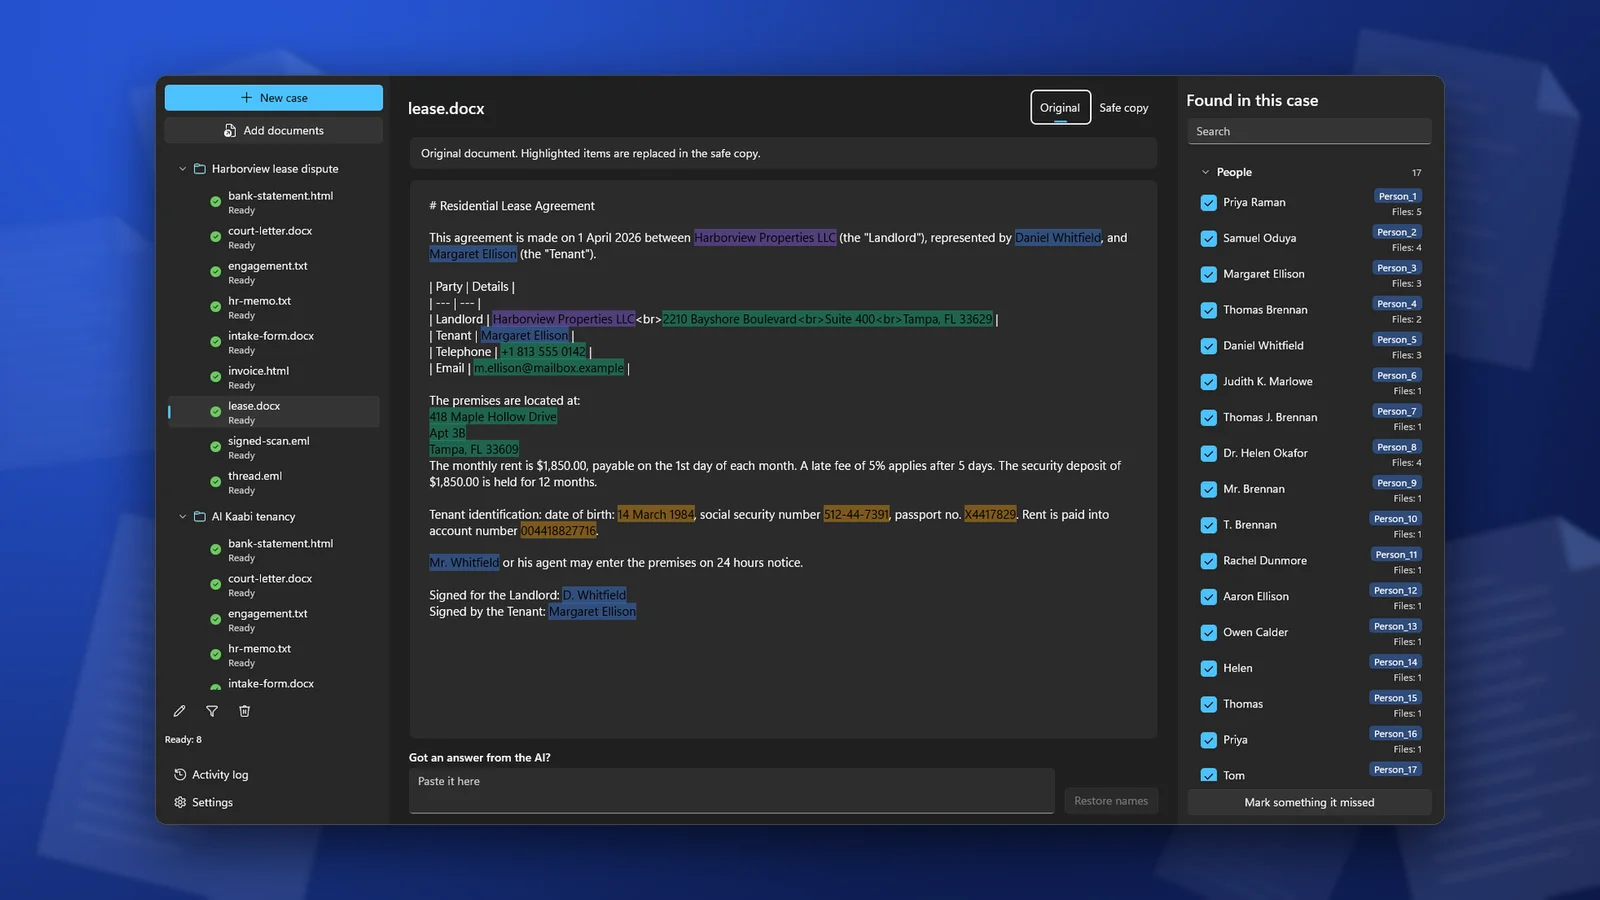
Dans ClientSafe, vous ajoutez les documents à un dossier, et il repère sur votre PC les noms, sociétés, adresses, numéros de téléphone, adresses e-mail, numéros de compte et d’identification et dates de naissance. Vous décochez ce qui n’est pas une donnée personnelle et marquez ce qui a été oublié. Puis vous copiez la copie sûre dans la conversation avec l’IA. Une même personne reçoit le même marqueur dans tous les documents du dossier.
La réponse revient avec des marqueurs
Le masquage fonctionne dans les deux sens. L’IA répond dans les termes que vous avez employés, donc sa réponse dit « Person_1 peut demander à Company_1… » plutôt que « Maria Lopez peut demander… ». Lui demander de garder les marqueurs tels quels, comme dans l’exemple ci-dessus, rend cela plus probable.
Remettez les vrais noms sur votre propre ordinateur, pas dans la conversation : un rechercher-remplacer avec votre liste de marqueurs, ou l’outil qui vous a servi à masquer. Relisez ensuite la réponse restaurée : un marqueur que l’IA a modifié (« Person 1 » au lieu de « Person_1 ») n’a peut-être pas été restauré. Notre guide pour restaurer les vrais noms dans la réponse de l’IA décrit l’aller-retour pas à pas.
Questions fréquentes
Un texte masqué est-il anonyme ?
Généralement non. Si vous gardez une table qui relie les marqueurs aux noms, le texte est pseudonymisé et, au sens du RGPD, il reste une donnée personnelle. Le masquage réduit ce que reçoit le service d’IA. Il ne fait pas sortir le texte du droit de la protection des données.
Faut-il masquer les noms de sociétés ?
Masquez la société du client et toute société qui permettrait d’identifier le client, comme une petite entreprise familiale. Une grande société cotée citée comme fournisseur ou contrepartie peut souvent rester, si la question en a besoin.
Le masquage dégrade-t-il la réponse de l’IA ?
Avec des marqueurs cohérents, rarement : l’IA voit toujours qui a fait quoi. La réponse se dégrade quand elle dépend de quelque chose que vous avez masqué, comme le pays ou l’âge d’une personne. Rajoutez ce détail sous une forme générale.
Puis-je simplement demander à l’IA d’ignorer les données personnelles ?
Non. Quand l’IA lit la consigne, les données ont déjà été envoyées. Le masquage doit avoir lieu avant de coller.
ClientSafe remplace sur votre PC les noms, adresses, numéros de téléphone, adresses e-mail, numéros de compte et d’identification et dates de naissance par des marqueurs, et remet les vrais noms dans la réponse de l’IA. La détection n’est pas parfaite : vérifiez la liste avant de copier.