Verfolgen Sie jeden Absatz bis zu seiner Fortsetzung. Unterbrechen Sätze aus der anderen Spalte den Text, korrigieren Sie die Reihenfolge vor Zusammenfassung oder Indexierung.
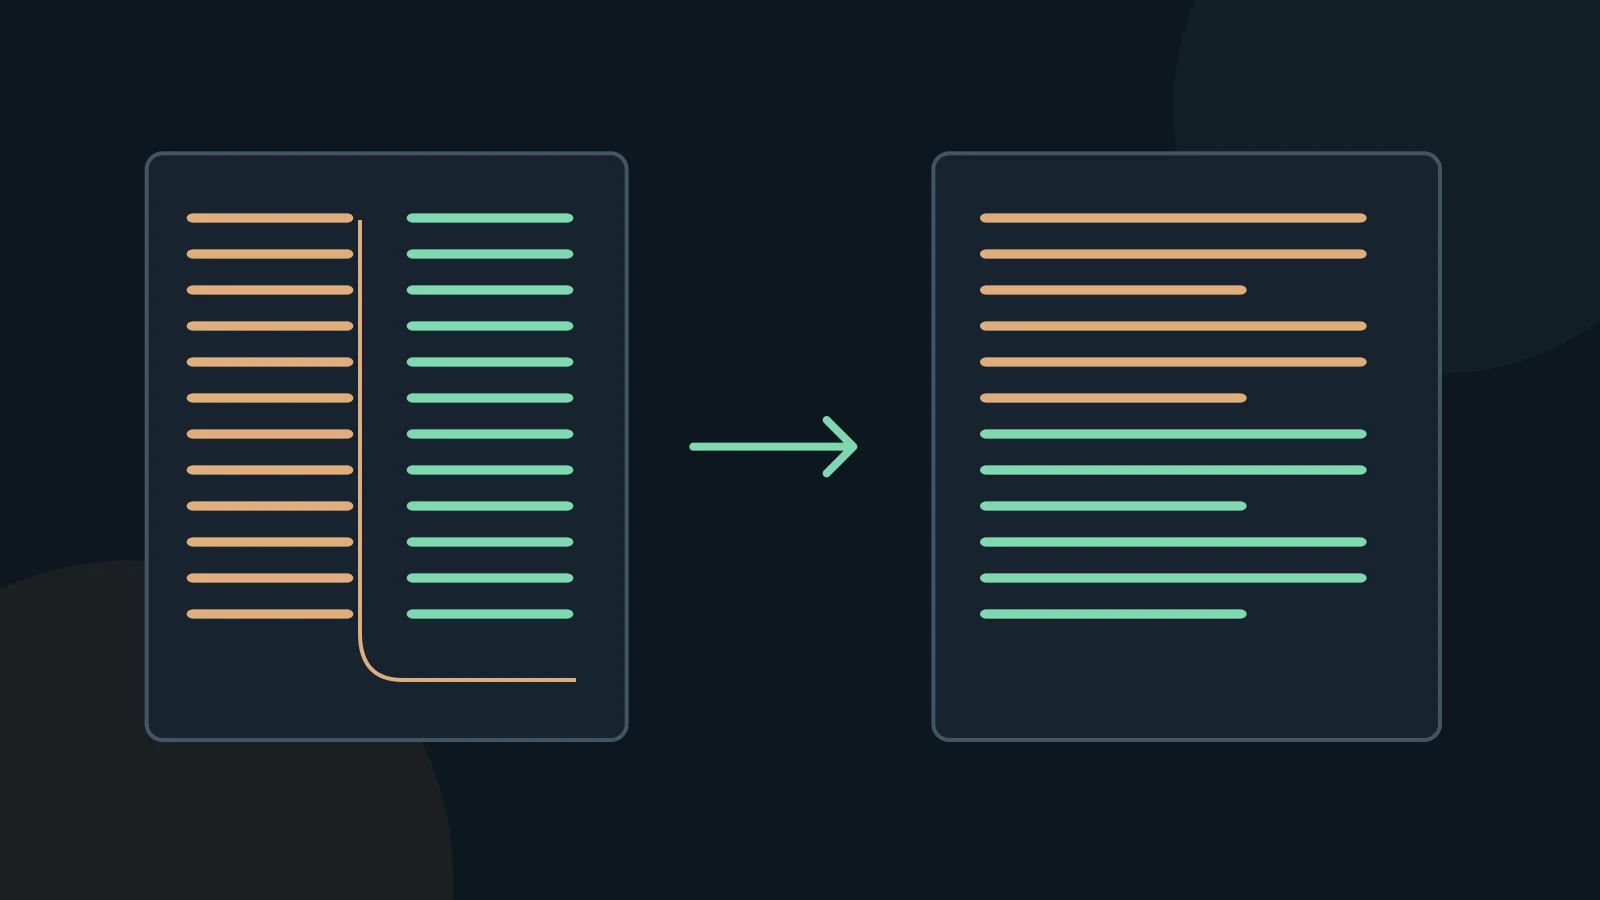
Vermischte Spalten erkennen
Manche Exporte wechseln zwischen einer linken und einer rechten Zeile. Andere setzen Bildunterschriften mitten in einen Satz. PDFBox erläutert, dass die Zeichenreihenfolge im PDF nicht der Lesereihenfolge entsprechen muss. Auch Positionssortierung ist keine Qualitätsgarantie.
Beginnen Sie mit einer Seite, deren Layout wechselt: breiter Titel, große Abbildung oder Abschnittsende. Prüfen Sie, ob zuerst die linke und danach die rechte Spalte gelesen wird. Folgen Sie bei anderen Layouts der Vorlage.
Zuerst eine Seite ordnen
- Suchen Sie den ersten und letzten Satz jeder Spalte im PDF und im Markdown.
- Verschieben Sie vollständige Absätze. Gleiche Zeilenhöhe ist kein Grund, Text aus verschiedenen Spalten zu verbinden.
- Setzen Sie breite Überschriften vor ihren Abschnitt. Halten Sie Bildunterschriften bei den Abbildungen und Fußnoten bei ihren Verweisen.
- Lesen Sie den letzten Absatz einer Seite mit dem ersten der nächsten. Prüfen Sie auf fehlende oder doppelte Fortsetzungen.
Die korrigierte Reihenfolge nachvollziehbar halten
Endet eine Zeile mit „Der zweite Versuch“ und lautet die Fortsetzung „verwendete eine kleinere Stichprobe“, gehört ein dazwischengeschobener Satz zur Finanzierung aus der anderen Spalte heraus. Prüfen Sie danach den ganzen Absatz, nicht nur einzelne Wörter.
Behalten Sie Abschnittsnamen und nützliche Seitenverweise. Kennzeichnen Sie eigenständige Randtexte, statt sie in die Argumentation einzufügen. Bei rechtsläufigen und gemischten Schriften muss die beabsichtigte Reihenfolge visuell geprüft werden.
Das Ergebnis vor der Verwendung prüfen
Die Konvertierung erstellt eine Arbeitskopie. Bewahren Sie das Original-PDF auf und vergleichen Sie alle Stellen, die Sie zitieren, für Berechnungen verwenden oder einer KI übergeben. Ein erfolgreicher Export bestätigt weder Vollständigkeit noch Richtigkeit.
MD Factory konvertiert Dokumente unter Windows in Markdown. Bei komplexen PDF-Tabellen verwendet die Erkennung Layout-Heuristiken; verbundene und mehrzeilige Zellen können Nacharbeit erfordern. Die OCR-Genauigkeit hängt von Bild und Text der Vorlage ab. Diese Anleitung verspricht weder automatische Bereinigung noch eine bestimmte Erkennungsgenauigkeit.
Fragen und Antworten
Behebt OCR die Lesereihenfolge?
Ein anderer Export kann anders ausfallen, aber neue Zeichenfehler enthalten. Prüfen Sie zunächst das Layoutproblem.
Kann ich einer schlüssigen KI-Zusammenfassung vertrauen?
Flüssiger Text kann vermischte Quellen verbergen. Prüfen Sie die Eingabe vor der Zusammenfassung.
Quellen und Prüfung
Quellen geprüft am 3. November 2026. Beschrieben wird eine manuelle Prüfung, keine zusätzliche Bedienfunktion von MD Factory.